Où ouvrir des entrepôts, quelle usine doit servir quel marché, quel camion doit livrer quel client ? Ces questions, en apparence différentes, ont un point commun. Les réponses possibles sont bien plus nombreuses que ce qu’une équipe peut examiner, et chacune doit respecter des règles qui ne se négocient pas.
Si l’on demande à un modèle de langage où installer son prochain entrepôt, on obtient une réponse. Elle est bien rédigée, elle s’accompagne d’une justification qui se tient, mais il est tout à fait possible qu’elle soit fausse. Dans un brouillon de courrier, l’erreur est sans conséquence et on la corrige en passant. Dans une décision de réseau logistique, qui engage plusieurs millions d’euros pour une dizaine d’années, elle ne se rattrape pas aussi facilement.
Plausible n’est pas fiable
Ce qui rend la chose délicate, ce n’est pas tant l’erreur elle-même que son apparence. La mauvaise réponse ressemble en tout point à la bonne. Elle a le même ton, la même assurance, la même présentation soignée.
C’est là, au fond, la force et la limite de l’IA générative, qui produit du plausible. Pour un courrier, le plausible suffit. Pour une décision qui engage l’entreprise, il faut davantage, à savoir une réponse dont on sait qu’elle respecte les contraintes et que l’on peut vérifier. Plausible n’est pas fiable, et toute la question est de savoir comment passer de l’un à l’autre.
Des décisions complexes qui comptent trop d’options
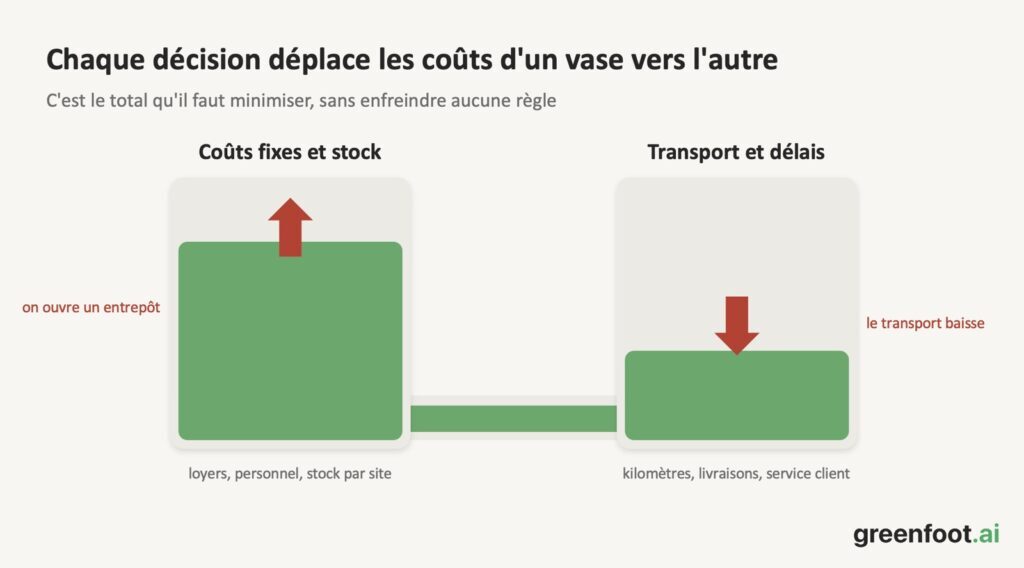
Ouvrir un entrepôt de plus coûte en loyer et en stock, mais rapproche les clients et réduit le transport. En fermer un fait l’économie inverse, au risque de saturer ceux qui restent et de dégrader les délais. Chaque décision déplace les coûts d’une poche vers une autre, comme des vases communicants, et c’est l’ensemble qu’il faut regarder. C’est cela, un problème d’optimisation. On cherche la combinaison qui coûte le moins au total, sans enfreindre aucune règle.
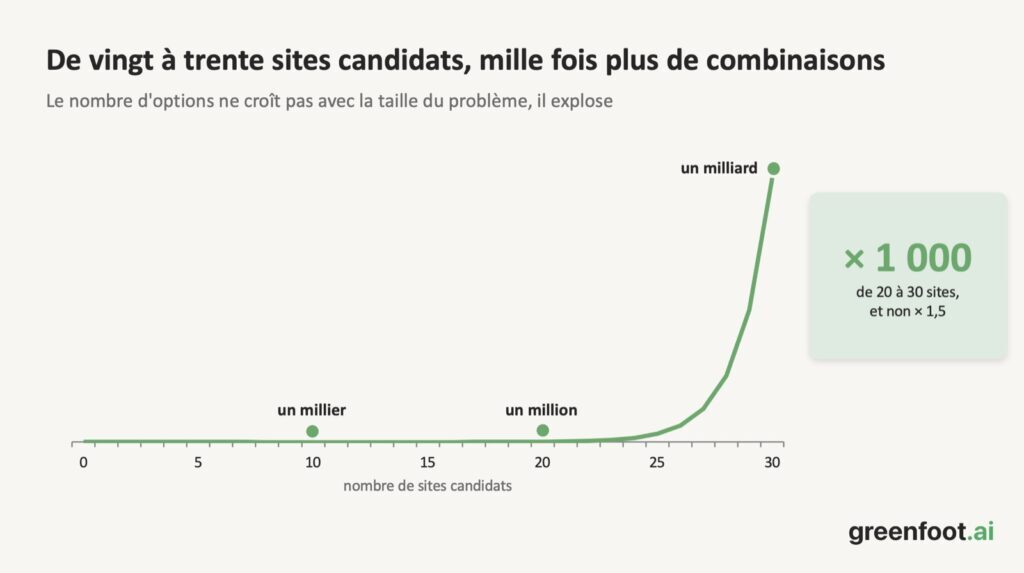
Prenons vingt sites candidats pour de nouveaux entrepôts. Le seul choix de ceux qu’on ouvre représente déjà plus d’un million de combinaisons. Si l’on ajoute la taille de chaque site, l’affectation des clients, les limites de capacité et les niveaux de service attendus, aucun tableur n’en vient à bout. Et le problème grossit drastiquement. En passant de vingt à trente candidats, on ne multiplie pas les options par une fois et demie, mais par mille. C’est ce qu’on appelle l’explosion combinatoire.
La décision complexe n’est pas affaire de goût
La recherche opérationnelle résout exactement ce genre de problèmes depuis des décennies, le plus souvent par la programmation linéaire en nombres entiers, que l’on désigne par son sigle anglais, MILP. Un solveur MILP n’essaie pas les combinaisons une à une. Il s’appuie sur des algorithmes qui lui permettent d’écarter des régions entières de l’espace des solutions sans avoir à les parcourir, et il aboutit à une solution dont l’optimalité est démontrée, ou bien à la démonstration qu’aucune solution ne satisfait l’ensemble des contraintes.
Un modèle de langage ne procède pas ainsi. Il ne cherche pas, il ne démontre rien et n’écarte rien. Il produit la suite de mots la plus probable qui pourrait répondre à la question. Posée deux fois, la même question peut donner deux répartitions différentes des volumes, sans que rien n’indique laquelle mérite confiance.
C’est d’ailleurs ce qui distingue l’optimisation des autres usages de l’IA générative. Si la qualité d’un résumé est une affaire de goût, une décision sous contrainte est optimale ou non, et parfois infaisable.
Les LLM ne savent pas dire non
La réponse ne tient pas à un meilleur prompt, ni à l’attente de la prochaine version du modèle, mais à une architecture où chacun tient son rôle. Le modèle de langage formalise. Il comprend la question métier, nettoie les données, repère les incohérences entre les sources, transforme les règles de gestion en contraintes, puis explique le résultat. Il ne calcule jamais la solution.
Le solveur décide. Avec les mêmes entrées, il rend le même résultat, à chaque fois, prouvé optimal ou prouvé infaisable. Il fait exactement ce qu’on lui demande, ni plus ni moins.
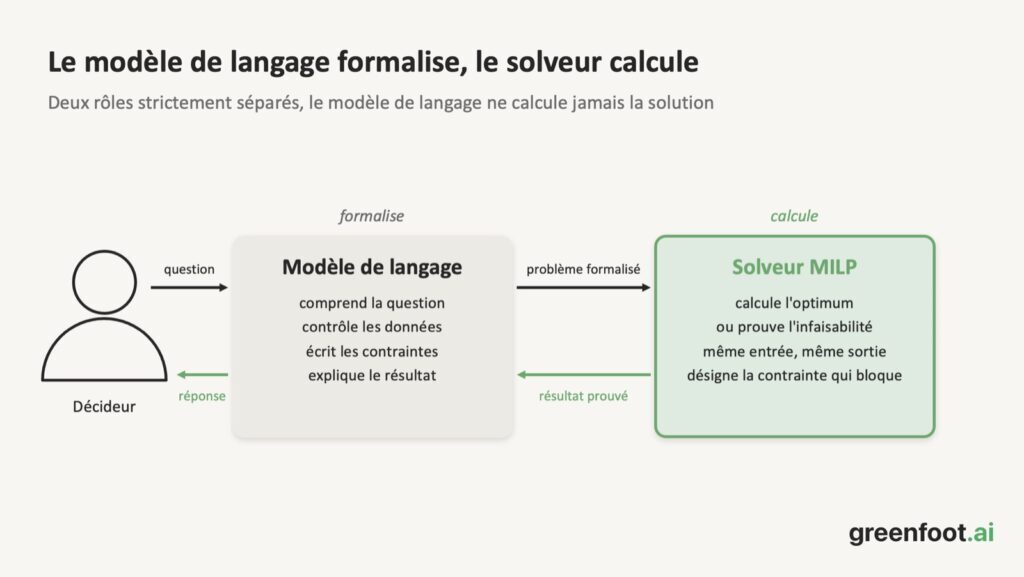
Il en découle que le système sait dire non, et dire pourquoi. Si l’on demande à un modèle de langage de livrer tous les clients en vingt-quatre heures depuis trois entrepôts qui n’en ont pas la capacité, il fournira un plan malgré tout, parce qu’il est conçu pour rendre service. Un solveur répondra que le problème est infaisable et désignera la contrainte qui bloque.
Ce que les LLM apportent, et pourquoi c’est nouveau
La demande en Espagne augmente de 30 % l’an prochain, à quoi ressemble le réseau ? On ferme Lyon, où partent ses volumes ? De nouveaux droits de douane frappent les importations chinoises, que donnerait un approvisionnement en Turquie ? Le modèle reformule l’hypothèse, le solveur recalcule, et la réponse arrive en quelques minutes, optimale et conforme à toutes les règles.
Si ces mathématiques ont cinquante ans et si peu d’entreprises y recourent, c’est que le coût n’a jamais été dans le calcul mais dans la formulation, ce travail de spécialiste qui traduit une opération réelle en contraintes et qui se périme dès que l’opération change. C’est ce coût que le modèle de langage fait tomber, en supply chain comme en ordonnancement de production, en tournées de véhicules ou en allocation de portefeuille.
Confieriez-vous la décision à une boîte noire ?
Les chats du moment, ChatGPT ou Claude, ne sont plus de simples modèles de langage. Ce sont des agents, équipés d’outils, et si on leur soumet le problème des vingt entrepôts, ils écrivent eux-mêmes un programme d’optimisation, l’exécutent et en rendent le résultat. Le calcul est délégué, ce qui confirme le principe.
Reste une question qu’un dirigeant se pose avant toute autre. Sur quoi repose ce chiffre ? Un comité d’investissement ne valide pas la fermeture d’un site sur la foi d’un montant apparu dans une fenêtre de conversation. Il veut savoir quelles données ont été utilisées, quelles règles ont été appliquées, quelles options ont été écartées et pourquoi, et il veut pouvoir refaire le calcul six mois plus tard et retrouver le même résultat. Or dans un chat, les données arrivent sans contrôle, le modèle mathématique est réécrit à chaque session, et rien de tout cela n’est conservé.
C’est cette traçabilité qui sépare une réponse d’une décision. Elle suppose un modèle fixe et testé, des contrôles de cohérence propres au métier, et une trace complète de chaque résultat. Greenfoot.ai est construit sur ce principe, pour un seul problème, la conception de réseaux supply chain.
Un modèle de langage donnera toujours une réponse. Seule la recherche opérationnelle peut dire si c’est la bonne, ou s’il en existe une.
Fayçal Ziraoui explore comment les mathématiques, l’intelligence artificielle et la recherche opérationnelle peuvent transformer la prise de décision dans les entreprises. Diplômé de l’École polytechnique et de HEC, il possède plus de quinze ans d’expérience dans le conseil en stratégie et transformation des opérations, avec une expertise dans la supply chain et l’optimisation des réseaux logistiques.
Entrepreneur et écrivain, auteur de L’Affaire du Zodiac (Robert Laffont, 2022 – adapté en série documentaire sur Canal+), il s’intéresse aux problèmes complexes et aux méthodes permettant de les résoudre.
Il est le fondateur de Greenfoot.ai, une solution qui associe agents d’IA générative et solveurs mathématiques pour rendre la conception des réseaux supply chain plus accessible, fiable et transparente.